

Le data mesh fait partie des concepts d'architecture qui reviennent dans les échanges de CODIR dès que l'IA devient un sujet sérieux. Le principe est séduisant : rendre chaque métier responsable de ses données pour sortir des silos et du goulot d'étranglement de l'équipe data centrale. Mais un data mesh PME, est-ce réaliste quand on compte 80, 200 ou 500 salariés et une équipe data de deux personnes ?
Nous avons géré des systèmes d'information pendant des décennies et vu passer beaucoup de modèles d'architecture présentés comme universels. Cet article fait le point sans complaisance : définition, comparaison avec les alternatives, coûts sourcés, et méthode pour reprendre les principes utiles sans surdimensionner votre organisation.
Temps de lecture : 10 minutes
Le data mesh en PME et ETI est-il réaliste en 2026 ?
1. Le data mesh expliqué simplement
2. Les quatre principes, lus avec un regard de dirigeant
3. Data mesh vs data warehouse, data lake, lakehouse et data fabric
4. Le data mesh en PME et ETI est-il réaliste ?
5. Combien coûte un projet data mesh ?
6. Ce que le data mesh change pour vos projets IA
7. Mettre en place un data mesh progressivement
8. Gouvernance et conformité, les risques à anticiper
9. Décider en dirigeant, pas en architecte
10. FAQ
Le data mesh expliqué simplement
Origine du concept de data mesh
Le concept a été formulé par Zhamak Dehghani lorsqu'elle travaillait chez ThoughtWorks. Il part d'un constat que nous retrouvons sur la plupart des SI que nous accompagnons.
Quand toutes les données remontent vers une équipe centrale chargée de les nettoyer, de les documenter et de les servir à tout le monde, cette équipe finit par devenir un goulot d'étranglement. Les métiers attendent, les demandes s'empilent, et les personnes qui transforment les données ne connaissent pas toujours le contexte métier qui leur donne du sens.
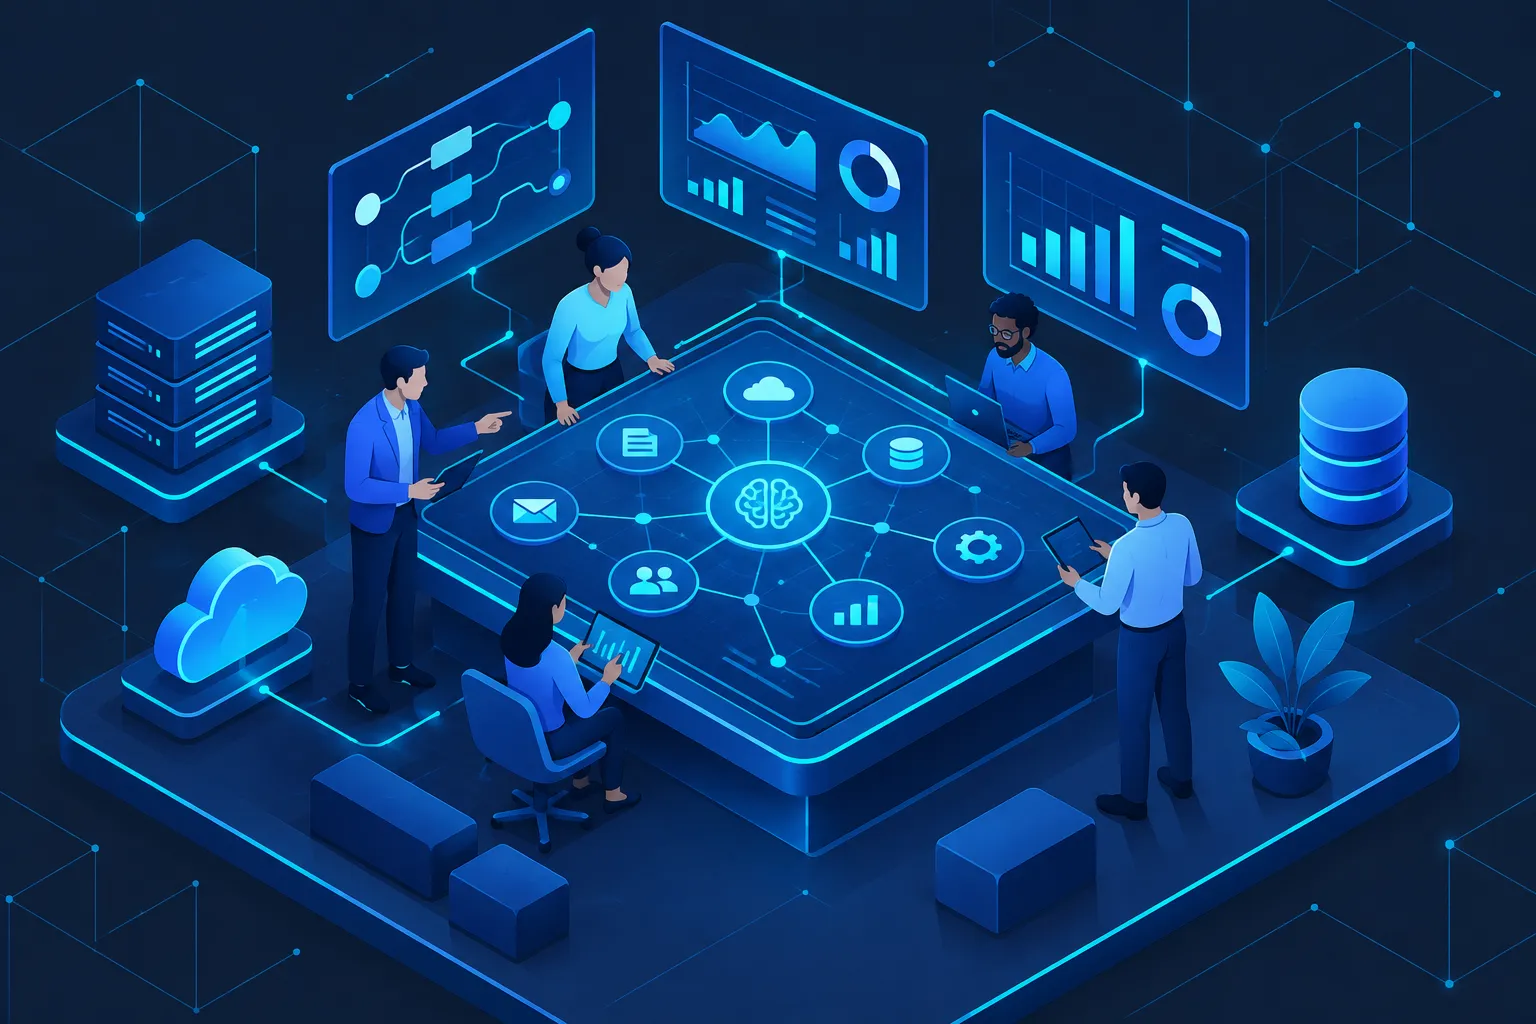
Le data mesh propose de renverser la logique. Chaque domaine métier, par exemple les ventes, la finance, la supply chain ou le service client, devient propriétaire des données qu'il produit. Il les documente, en garantit la qualité et les met à disposition des autres équipes sous une forme réutilisable. Ce n'est donc pas d'abord une technologie mais un modèle d'organisation, ce que beaucoup de projets oublient.
Les quatre principes, lus avec un regard de dirigeant
Traduction des principes pour une entreprise de taille intermédiaire
Le data mesh repose sur quatre principes qui ont chacun une traduction concrète dans une entreprise de taille intermédiaire.

Le premier est la responsabilité par domaine. Les équipes métier répondent de la qualité, de la disponibilité et de la compréhension de leurs données, au lieu de tout déléguer à l'équipe data. Concrètement, cela suppose un propriétaire de données (data owner) identifié pour chaque ensemble important.
Le deuxième est la donnée considérée comme un produit, ce que l'on appelle data as a product. Un produit de données doit être découvrable, documenté, fiable et conçu pour ses consommateurs internes, notamment les équipes analytiques et les projets IA. Dans une PME comme dans une ETI, c'est sans doute le principe qui apporte le plus de valeur pour le moins d'effort.
Le troisième est la plateforme de données self-service. Une équipe plateforme fournit à tous les domaines les mêmes outils d'ingestion, de transformation, de catalogage, de supervision et de contrôle, pour éviter que chaque métier réinvente sa propre chaîne technique.
Le quatrième est la gouvernance fédérée. Les règles communes (sécurité, nommage, qualité, conformité) sont définies de manière transverse, puis appliquées au plus près des domaines. Les contrats de données (data contracts) formalisent ce lien entre producteurs et consommateurs : schéma, fréquence de mise à jour, niveau de qualité attendu, disponibilité et règles d'évolution.
À retenir
Un data mesh sans propriétaires de données réellement disponibles et sans règles communes n'est pas une architecture décentralisée, c'est un retour aux silos avec des outils plus coûteux.
Data mesh vs data warehouse, data lake, lakehouse et data fabric
Choisir l'approche adaptée à votre organisation
La confusion vient souvent du fait que l'on compare des choses de nature différente. Le data warehouse, le data lake et le lakehouse sont des architectures de stockage et de traitement, majoritairement centralisées. Le data mesh est un modèle de répartition des responsabilités, qui peut d'ailleurs s'appuyer sur un lakehouse comme socle technique. Le data fabric, lui, désigne une couche d'intégration et de gouvernance plus automatisée qui relie des sources hétérogènes. Le tableau ci-dessous résume les différences.
Comparaison des approches data pour une PME ou une ETI
• Approche: Data warehouse Logique principale: Données structurées, centralisées, orientées reporting Pertinence probable pour une PME ou une ETI: Souvent le meilleur point de départ pour la BI et les premiers projets IA
• Approche: Data lake Logique principale: Stockage central de données structurées et non structurées Pertinence probable pour une PME ou une ETI: Adapté à des volumes variés, à condition d'avoir une gouvernance solide
• Approche: Lakehouse Logique principale: Stockage flexible et fonctions analytiques structurées réunis Pertinence probable pour une PME ou une ETI: Option intermédiaire pour réunir BI, analytique et IA sur un même socle
• Approche: Data mesh Logique principale: Responsabilité distribuée par domaine, données traitées comme des produits Pertinence probable pour une PME ou une ETI: Pertinent lorsque la complexité et l'autonomie des domaines le justifient
• Approche: Data fabric Logique principale: Intégration et gouvernance automatisées entre systèmes existants Pertinence probable pour une PME ou une ETI: À étudier selon les outils déjà en place et le nombre de systèmes à connecter
La question « data mesh ou lakehouse » est donc souvent mal posée. Dans la majorité des entreprises que nous accompagnons, la bonne réponse est un lakehouse ou un data warehouse bien gouverné, sur lequel on applique progressivement certains principes du data mesh. Nous détaillons les choix de socle dans notre article sur l'architecture de données pour l'IA.
Le data mesh en PME et ETI est-il réaliste ?
La réponse dépend moins du nombre de salariés que de la complexité organisationnelle, du nombre de domaines métier, du volume de sources et de la maturité data. Selon notre expérience, une entreprise de 150 personnes avec un ERP, un CRM et un outil de support n'a pas le même besoin qu'une ETI de 450 salariés issue de trois acquisitions, avec plusieurs filiales autonomes et autant de systèmes à réconcilier.
Le data mesh mérite d'être étudié lorsque plusieurs des situations suivantes se cumulent :
• plusieurs domaines métier produisent des données critiques et fonctionnent avec une réelle autonomie ;
• l'équipe data centrale ne parvient plus à répondre dans des délais acceptables ;
• des projets IA exigent de croiser des données issues de plusieurs équipes ;
• des responsables métier peuvent effectivement prendre en charge la qualité et la documentation ;
• une plateforme commune peut être financée et maintenue dans la durée ;
• la direction accepte une transformation organisationnelle, pas seulement un chantier technique.
À l'inverse, une architecture mesh complète est presque toujours prématurée si l'entreprise compte peu de systèmes, une seule équipe data, des besoins surtout orientés reporting et une gouvernance des données encore inexistante. Pour une petite entreprise de moins de 50 salariés, le sujet est en pratique hors de portée et hors de propos : la priorité est d'avoir des indicateurs définis et une donnée fiable.
Ce que nous constatons chez nos clients, c'est que la difficulté n'est presque jamais technique. Elle tient à la disponibilité des experts métier, qui ont déjà un travail à temps plein et à qui l'on demande soudain de devenir responsables d'un produit de données.
Combien coûte un projet data mesh ?
Les chiffres publiés sont indicatifs et varient fortement selon le périmètre, mais ils donnent un ordre de grandeur utile pour un arbitrage de CODIR. Une analyse publiée par Data Engineering Companies estime un pilote data mesh entre 150 000 et 400 000 dollars, sur une durée typique de trois à six mois, et une transformation complète à l'échelle de l'organisation sur 12 à 24 mois ou davantage. Le cabinet Data Science Consulting Pro situe une mission d'évaluation de maturité et d'architecture entre 2 500 et 7 500 dollars, et une mission de feuille de route entre 7 500 et 20 000 dollars.

Côté français, Flowt évalue le modèle décentralisé entre 300 000 et 600 000 euros annuels pour certaines organisations de 50 à 250 salariés, tout en précisant qu'il convient surtout aux structures très matures. Les postes de dépense couvrent la plateforme, le cloud, le catalogue de données, l'intégration, l'orchestration, la sécurité, la formation et, poste souvent sous-estimé, le temps des experts métier.
Important
Le coût le plus élevé d'un data mesh n'apparaît dans aucun devis. C'est le temps que vos responsables métier consacreront durablement à leurs produits de données, et il doit être arbitré comme un investissement à part entière.
Ce que le data mesh change pour vos projets IA
C'est l'argument qui ramène le sujet sur la table de nombreux CODIR. Un projet IA ne vaut que par la qualité de ses données d'entraînement, de validation et de production. Sur les SI que nous accompagnons, une grande partie des POC qui ne passent jamais en production butent sur ce point précis : données mal documentées, schémas qui changent sans prévenir, indicateurs définis différemment d'une direction à l'autre.
Les principes du data mesh répondent directement à ces difficultés. Des produits de données documentés et dotés d'un propriétaire peuvent alimenter à la fois les tableaux de bord, les modèles prédictifs, les assistants internes et les bases de connaissances. Les contrats de données réduisent le risque de rupture lors d'un changement de schéma dans un pipeline ELT ou ETL. Le lignage des données (data lineage) et les métadonnées facilitent la supervision des modèles et la traçabilité exigée par la réglementation. Les cas d'usage qui en bénéficient le plus sont ceux qui croisent plusieurs domaines, comme la prévision de la demande, la détection d'anomalies ou l'automatisation du support.
Autrement dit, ce n'est pas l'architecture mesh en tant que telle qui accélère l'industrialisation du machine learning, ce sont la responsabilité explicite et la qualité des données qu'elle impose. Ces deux leviers sont accessibles sans transformation complète, et ils conditionnent le passage du prototype à la production que nous traitons dans nos missions de pilotage et de mise à l'échelle.
Mettre en place un data mesh progressivement
Une démarche par étapes pour les PME et ETI
Pour la majorité des PME et des ETI, la démarche la plus rentable consiste à adopter les principes sans déployer d'emblée toute l'architecture. Voici la séquence que nous recommandons.
La première étape est un état des lieux honnête : cartographier les sources, les propriétaires réels, les utilisateurs, les niveaux de qualité, les flux et les contraintes réglementaires, puis évaluer la maturité data. C'est l'objet même d'un Diagnostic IA, qui révèle souvent des usages non gouvernés et un état des données assez éloigné de ce que l'organigramme laisse supposer. Sa durée et son budget dépendent du périmètre : nombre de directions et de sites, processus à couvrir, état des données.
La deuxième étape consiste à choisir un pilote et un cas d'usage prioritaire. Le premier domaine doit réunir trois conditions : une valeur métier mesurable, un responsable motivé et disponible, et des données déjà relativement maîtrisées. Selon notre expérience, les domaines commandes, clients ou stocks remplissent souvent ces critères, car ils alimentent des usages transverses comme la prévision des ventes. Le pilote doit être suivi par des indicateurs simples : délai de mise à disposition, qualité des données, taux de réutilisation, temps de mise en production d'un modèle.
La troisième étape fixe les responsabilités et les standards. On nomme un propriétaire par produit de données, on constitue une équipe plateforme légère, parfois une ou deux personnes de la DSI, et l'on définit les règles minimales : nommage, formats, métadonnées, fréquence de mise à jour, gestion des incidents, niveaux d'accès. Un catalogue de données léger suffit au départ. Le référentiel DAMA-DMBOK reste une bonne base pour structurer ces rôles sans réinventer la gouvernance des données.
La dernière étape consiste à mesurer avant d'étendre. Qualité, adoption, coûts et impact métier sont évalués avant d'ouvrir un deuxième domaine. Les recommandations publiées convergent avec ce que nous observons sur le terrain : commencer avec un ou deux domaines, jamais davantage.
Bon à savoir
Un data mesh exemple de mise en œuvre réussie en ETI ressemble rarement à un grand projet. C'est le plus souvent un lakehouse existant sur lequel deux ou trois domaines publient des produits de données avec contrat et propriétaire, et qui s'étend au rythme de la valeur démontrée.
Gouvernance et conformité, les risques à anticiper
La décentralisation déplace les risques plus qu'elle ne les supprime. Sans standards communs, plusieurs domaines produisent des jeux de données similaires, des indicateurs contradictoires ou des pipelines redondants. Une gouvernance fédérée mal définie peut aussi créer des failles d'accès et de sécurité, en particulier sur les données personnelles. Au regard du RGPD, chaque produit de données contenant des informations sur des clients ou des salariés doit avoir une finalité, une base légale, une durée de conservation et des droits d'accès clairement établis, conformément aux recommandations de la CNIL.

Avec l'entrée en application progressive de l'AI Act, la traçabilité des données d'entraînement devient en outre une exigence pour certains systèmes d'IA. C'est un point où le data mesh peut aider, à condition que le lignage et les métadonnées soient imposés par la plateforme commune et non laissés à la bonne volonté de chaque domaine. Pour une approche structurée de ces obligations, notre article sur la conformité RGPD et AI Act détaille les points de contrôle. La place de la souveraineté compte aussi : l'hébergement de la plateforme dans l'Union européenne simplifie nettement la maîtrise des transferts de données.
Décider en dirigeant, pas en architecte
Le data mesh n'est ni une mode à ignorer ni une cible à atteindre à tout prix. Pour la plupart des PME et des ETI, c'est une boîte à outils dont il faut prendre les meilleurs principes : propriétaire identifié, données traitées comme des produits, contrats de données, catalogue léger et gouvernance pragmatique.
L'architecture complète devient pertinente lorsque la croissance, la multiplication des domaines et les projets IA rendent le modèle centralisé trop lent. La vraie question n'est donc pas technique. Elle porte sur l'organisation que votre CODIR est prêt à porter, et sur les cas d'usage qui justifient l'effort.
FAQ
Faut-il une équipe data dédiée pour adopter un data mesh ?
Une équipe plateforme est indispensable, même réduite, pour fournir les outils et les garde-fous communs. En revanche, le data mesh vise précisément à ne pas faire reposer toute la croissance sur l'effectif de l'équipe data centrale. Dans une entreprise de taille intermédiaire, une ou deux personnes côté DSI, associées à des propriétaires métier formés, suffisent souvent pour un premier pilote.
Peut-on adopter les principes du data mesh sans changer toute son architecture ?
Oui, et c'est ce que nous recommandons dans la majorité des cas. Les principes de responsabilité par domaine, de documentation et de contrats de données s'appliquent très bien sur un data warehouse ou un lakehouse existant. On conserve le socle technique et l'on fait évoluer l'organisation autour.
Quand privilégier un lakehouse plutôt qu'un data mesh ?
Lorsque l'entreprise dispose d'une seule équipe data, d'un nombre limité de systèmes et de besoins concentrés sur le reporting et quelques cas d'usage IA. Le lakehouse réunit BI, analytique et IA sur un socle unique, plus simple à exploiter et à sécuriser. Il reste compatible avec une évolution future vers une organisation par domaines.
Qui doit porter la décision d'un data mesh dans l'entreprise ?
La décision relève du CODIR et non de la seule DSI, puisqu'elle engage le temps des directions métier et modifie les responsabilités. Aligner les membres du CODIR sur un langage commun et sur les irritants réels de chaque direction est un préalable, c'est le rôle d'un atelier de cadrage de quatre heures comme notre Atelier IA CODIR, dont le budget est souvent compris entre 5 000 et 7 000 € HT selon la taille de l'entreprise.
Comment savoir si notre maturité data est suffisante ?
Quelques signaux sont parlants : des indicateurs clés définis de la même manière par toutes les directions, des propriétaires de données identifiés, une documentation minimale des sources et une politique d'accès formalisée. Si ces bases manquent, elles constituent le premier chantier, bien avant toute réflexion sur une architecture de données décentralisée.